2026年10月19日 ∙ 阅读14分钟
大多数小企业想要的 AI 功能无非就是那么几项。他们想起草邮件、总结通话、读取发票、搜索自己的文档,偶尔再做张图。其中不少企业无法为此把客户数据发送到云端 API。
原因通常是数据隐私和主权。诊所、律师事务所或会计师事务所可能持有这样的记录:合同、监管机构或职业义务要求这些记录必须处于其控制之下。一旦这些数据进入云端 API,它就会存放在别人的硬件上,可能位于另一个司法管辖区,并受服务提供商可随时更改的条款约束。在你拥有的硬件上运行模型,可以将数据保留在你的场所内,并让你能向审计人员准确展示数据的去向。
你的 n8n 工作流可以转录通话、读取发票、根据你自己的文档回答问题,并起草回复,而无需向云 API 发送一个字节。本文展示如何从一台 NVIDIA DGX Spark 上为这些工作流所需的每一个模型提供服务,并置于一个 OpenAI 兼容端点之后,而 n8n 的 OpenAI 节点已经能够使用该端点。
一台 DGX Spark 拥有由 CPU 和 GPU 共享的 128GB 统一内存。如果选对模型,这足以让所有这些任务同时保持加载状态。本文大部分内容讲的就是这个。
自托管 AI 入门套件让一个人就能在笔记本电脑上运行本地模型。下一步是:办公室中的一台设备,为整个团队提供服务,每项任务都有对应的模型以及运行它的代码。
在这篇文章中,你将:
选择能在 DGX Spark 的内存带宽上快速运行的模型
使用 vLLM 以 NVFP4 部署一个 35B 混合专家模型
将完整的 AI 技术栈装入单机的共享内存中
让每个作业都通过一个 LiteLLM 端点进行路由,并使用各团队专属密钥
将 n8n 连接到该技术栈,并构建一个从不调用云 API 的工作流
测量当有人生成图像时聊天速度会发生什么变化
选择模型要看带宽,而不是参数量
DGX Spark 的 GB10 Grace Blackwell 超级芯片的内存读取速度为 273 GB/s。模型生成文本时,每生成一个 token 都会从内存中读取其活跃权重,因此读取的字节越少,运行速度就越快。
混合专家(MoE)模型每个 token 只激活少数专家。Qwen3.6-35B-A3B 总共有 35B 参数,但约 3B 处于激活状态。以 NVFP4(NVIDIA 的 4 位浮点格式)存储时,这些激活权重仅相当于稠密模型的一小部分。
在我的 DGX Spark 上,Qwen3.6-35B-A3B 为单个用户生成了每秒 120 个 token,在八个用户总计每秒 359 个 token。这些数字包括模型在回答之前写出的推理 token。
这就给出了第一条设计规则:用一个强大的MoE模型处理所有文本形态的任务。总结、分类、提取、起草、编码和阅读截图都交由同一个模型完成。每多一个模型,就多一个需要固定、打补丁和监控的容器,因此专用模型只有在LLM无法胜任的地方才有一席之地。
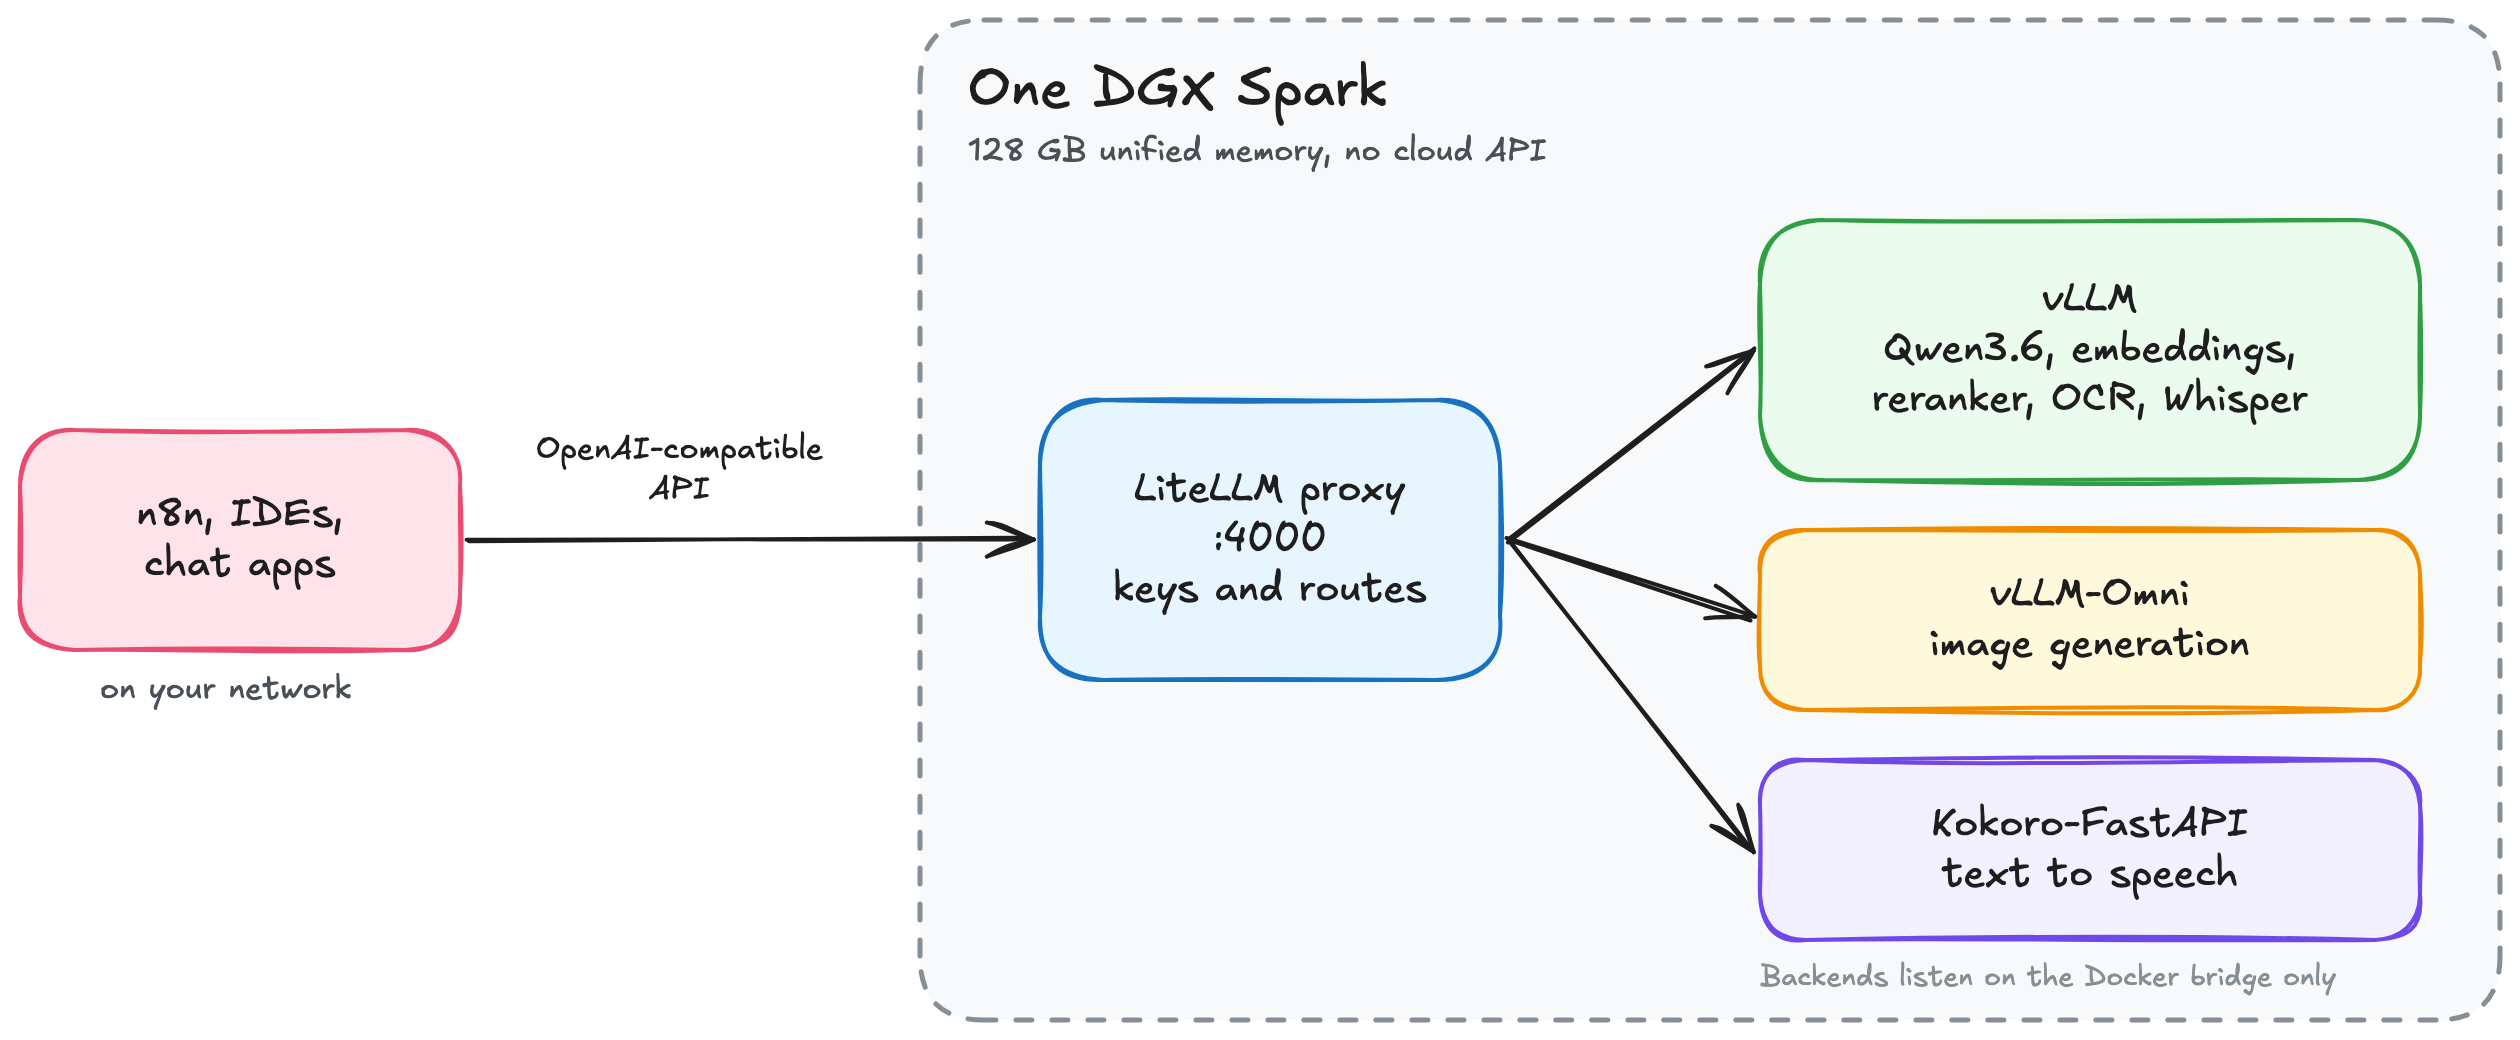
这些是保持加载在一台 DGX Spark 上的模型:
技术栈中的每个模型都允许商业使用。这条规则付出的代价比任何技术规则都大,后面有一节专门讲它。
第 1 步:缓存所有内容以供离线使用
这套技术栈必须在拔掉网线的情况下运行,因此请将每个模型下载一次,并记录你获取到的确切提交。这个循环会缓存每个模型,并写入一个包含仓库和提交的锁文件:
启动模型时,使用 models.lock 中的提交传入 --revision。这样 vLLM 提供的是你测试过的权重,而不是 main 当前指向的任何内容,因此上游变更无法在你不知情的情况下替换权重或许可证。
检查 vLLM 版本,而不是标签
用同样的方式固定容器(版本),并检查里面有什么。我第一次尝试使用了 vLLM 的 cu130-nightly 标签。那个标签已停止更新,它拉取的镜像已有五个月之久,里面是 vLLM 0.19。它完全无法加载 Qwen3.6。错误信息没有提到版本。它们是一个因缺少 weight-scale 参数而引发的 KeyError,看起来像是检查点损坏。
在你信任一个镜像之前,请打印其中的 vLLM 版本:
能用的镜像是官方 vllm/vllm-omni:v0.30.0,它附带 vLLM 0.30.0 的 arm64 构建。vLLM-Omni 是完整的 vLLM,额外提供用于图像和语音的服务模式,因此也能服务普通 LLM。它的默认入口点不是 vllm serve,所以需要包装一次:
Kokoro-FastAPI 镜像需要一项社区修复才能在 arm64 上构建。Dockerfile 来自 swann.schilling 在 NVIDIA 开发者论坛上发布的帖子。
步骤 2:为骨干服务
此命令在 vLLM 中启动主模型:
在我的 DGX Spark 上,执行 docker run 后 311 秒,该模型就已准备好提供服务。
该端口发布在 172.17.0.1(Docker 的桥接地址)上,因此只有本机上的容器才能访问它。VLLM_API_KEY 会让 vLLM 拒绝任何没有该密钥的请求。
在 DGX Spark 上最重要的标志:
--gpu-memory-utilization 0.32 将该模型的内存限制在大约三分之一。其他模型需要剩余部分。
--kv-cache-dtype fp8 将 KV 缓存所需的内存减半,因此同样的预算可以容纳更多上下文。
--moe-backend marlin 为量化专家层选择内核。草稿模型的专家并未量化,因此 --speculative-config 会设置它自己的 moe_backend。
--speculative-config 开启多 token 预测(MTP)。模型会向前草拟三个 token,并在一次前向中检查它们。
--reasoning-parser 和 --tool-call-parser 必须与模型系列匹配。当工具调用失败时,先检查这些标志,再怪模型。
查看启动日志中 vLLM 选择的内核。下面这些行来自我的运行:
最后那条警告会影响你如何理解 DGX Spark 上的“NVFP4”。在这个 vLLM 构建中,权重以 4 位存储,但数学运算以 16 位运行。你仍然能获得大部分收益,因为生成 token 受限于从内存读取权重,而 4 位权重只有四分之一大小。面向 GB10 的更快的 FP4 内核可能会在后续构建中提高这些数字。
在 DGX Spark 上,GPU 和操作系统共享一个 128GB 内存池。Linux 在我的机器上将其中 121GB 报告为总内存。这会改变你在独立 GPU 上可能认为理所当然的两件事。
第一,--gpu-memory-utilization 是整个内存池的比例,在启动时取值。它不是可用内存的比例。没有上限的实例会试图占用几乎所有内存,导致下一个模型无法启动。
第二,vLLM 会根据启动时的可用内存来确定其缓存大小。一次启动两个模型,它们会争夺同一块内存。一次启动一个,并等待每个模型通过健康检查后再启动下一个:
如果模型因 CUDA error: out of memory 失败,而可用内存显示充足,那么是 Linux 页缓存占着它。这在刚下载完 220GB 权重后很常见。清掉缓存,然后重新启动模型:
下面是先清掉页缓存后,每个服务冷加载所花的时间,以及它占用的内存:
嵌入模型在 vLLM 0.30.0 上还需要一个标志 --convert embed,并且启动得更晚,在其余服务之后。七个模型全部加载后,DGX Spark 使用了 108GB,并有 13GB 可用。这就是一台 DGX Spark 能容纳的上限。要在任何人需要之前尽早启动这套栈:表中的六个服务大约花了 12 分钟。
vLLM 还可能在启动时因 Error in memory profiling 失败,当 vLLM 测量可用内存时,另一个进程释放了内存。在共享内存上,如果另一个模型正在加载或关闭,就会发生这种情况。等机器安静下来后,再重新启动模型。
第 4 步:在前面放一个端点
LiteLLM 为每个客户端提供一个兼容 OpenAI 的端点。每个作业都是一个命名路由,因此你可以在不改动任何客户端的情况下,替换某个路由背后的模型。LiteLLM 的开源版本还处理虚拟密钥、团队和预算。
LiteLLM 的 config.yaml 中,每个路由都指向一个后端。下面这段摘录展示了其中三个:
保留 drop_params: true。没有它,LiteLLM 会以 400 错误拒绝任何设置了 response_format 的图像请求,因为它不会为自托管图像模型映射该字段。保留它时,LiteLLM 会丢弃该字段,而 vLLM-Omni 仍会以 base64 返回图像。
LiteLLM 也运行在 Docker 中。为了让它能访问后端,在其 Compose 服务中将 host.docker.internal 映射到宿主机:
后端只监听 Docker 的桥接网络,并要求共享密钥,因此 LiteLLM 是办公网络上唯一的服务。让 LiteLLM 指向桥接网络,而不是这台机器的 LAN 地址。如果你使用 LAN 地址,后端会拒绝连接,因为它们没有在那里监听。
通过镜像摘要固定 LiteLLM,并使用 1.84.0 或更高版本。2026 年 3 月有两个 PyPI 发布版本被植入后门,1.84.0 修复了两个认证绕过问题。我运行的是 1.99.1。
现在任何 OpenAI 客户端都可以对 DGX Spark 使用。这个 Python 示例通过同一个客户端调用三个不同模型:
num_inference_steps 不是 OpenAI 参数,所以它放在 extra_body 中。LiteLLM 会将它传递给 vLLM-Omni。下一节会解释它为什么重要。
第 5 步:连接 n8n
n8n 的 OpenAI 凭据接受自定义 base URL,因此 n8n 可以像与 OpenAI 通信一样与 DGX Spark 通信。要将 n8n 指向 DGX Spark,请按以下步骤操作:
为拥有这些工作流的团队创建一个 LiteLLM 虚拟密钥,并限制为他们需要的路由。此命令使用 LiteLLM 主密钥创建一个密钥并打印出来: