蚂蚁集团与 vLLM 社区正在开源 Humming,一个面向量化推理的通用高性能内核库。Humming 提供以下特性:
广泛的设备支持:支持从 Turing 开始的 NVIDIA GPU 架构,以及 CUDA 兼容设备,例如 T-Head 的 Zhenwu 810E。
广泛的量化支持:统一架构支持稠密和 MoE 工作负载中权重与激活格式的多样化组合,覆盖广泛的整数和浮点类型、位宽和缩放方案。
强劲的执行性能:在许多代表性工作负载上显著优于 vLLM Marlin、FlashInfer 和 DeepGEMM 的现有实现。
代码仓库:github.com/vllm-project/humming
随着模型和推理工作负载增长,内存容量、内存带宽和计算成本日益制约部署。这在 MoE 模型中尤为明显:每个 token 仅激活一部分专家,但完整权重集仍需存储。例如,DeepSeek-V3 拥有 6710 亿参数,每个 token 激活 370 亿参数。量化降低权重和激活的精度,以减少内存占用和数据移动,还能提升计算效率。
量化需求因模型和 GPU 代际而异。常见配置包括 WNA16、W8A8、W4A8 和 W4A4,其中 W 和 A 表示权重和激活位宽,N 表示可变权重位宽。即使精度相同,INT4 和 NVFP4 等方案在数值格式和缩放方面也不同。缩放粒度、缩放表示、分组大小以及对称或非对称量化进一步扩展了配置空间。
只有借助高效内核,这些存储和计算节省才能转化为更低的延迟和更高的吞吐量。预填充、解码以及变化的 MoE 专家负载对计算和内存提出不同需求。内核必须适应这些工作负载,同时保持转换、反量化和调度开销较低。
为每种组合开发和集成专用内核会产生日益增长的维护负担。每次新增都可能需要自己的权重预处理、内核选择、框架适配器和测试。随后优化还必须在多个实现之间沿用。
Humming 通过将量化描述与执行选择分离,并由共享组件组合内核,解决了这个问题。
通用架构
Humming 的执行路径分为三部分:表示量化计算,为硬件和工作负载选择配置,以及从 CUDA 组件编译内核。
统一的量化表示
不同量化工具导出的模型在数值格式、参数组织和权重布局上各不相同。Humming 将支持的导出格式转换为 Humming 标准格式:一种通用的量化描述,其中权重、缩放、零点和其他张量以一致的方式组织。
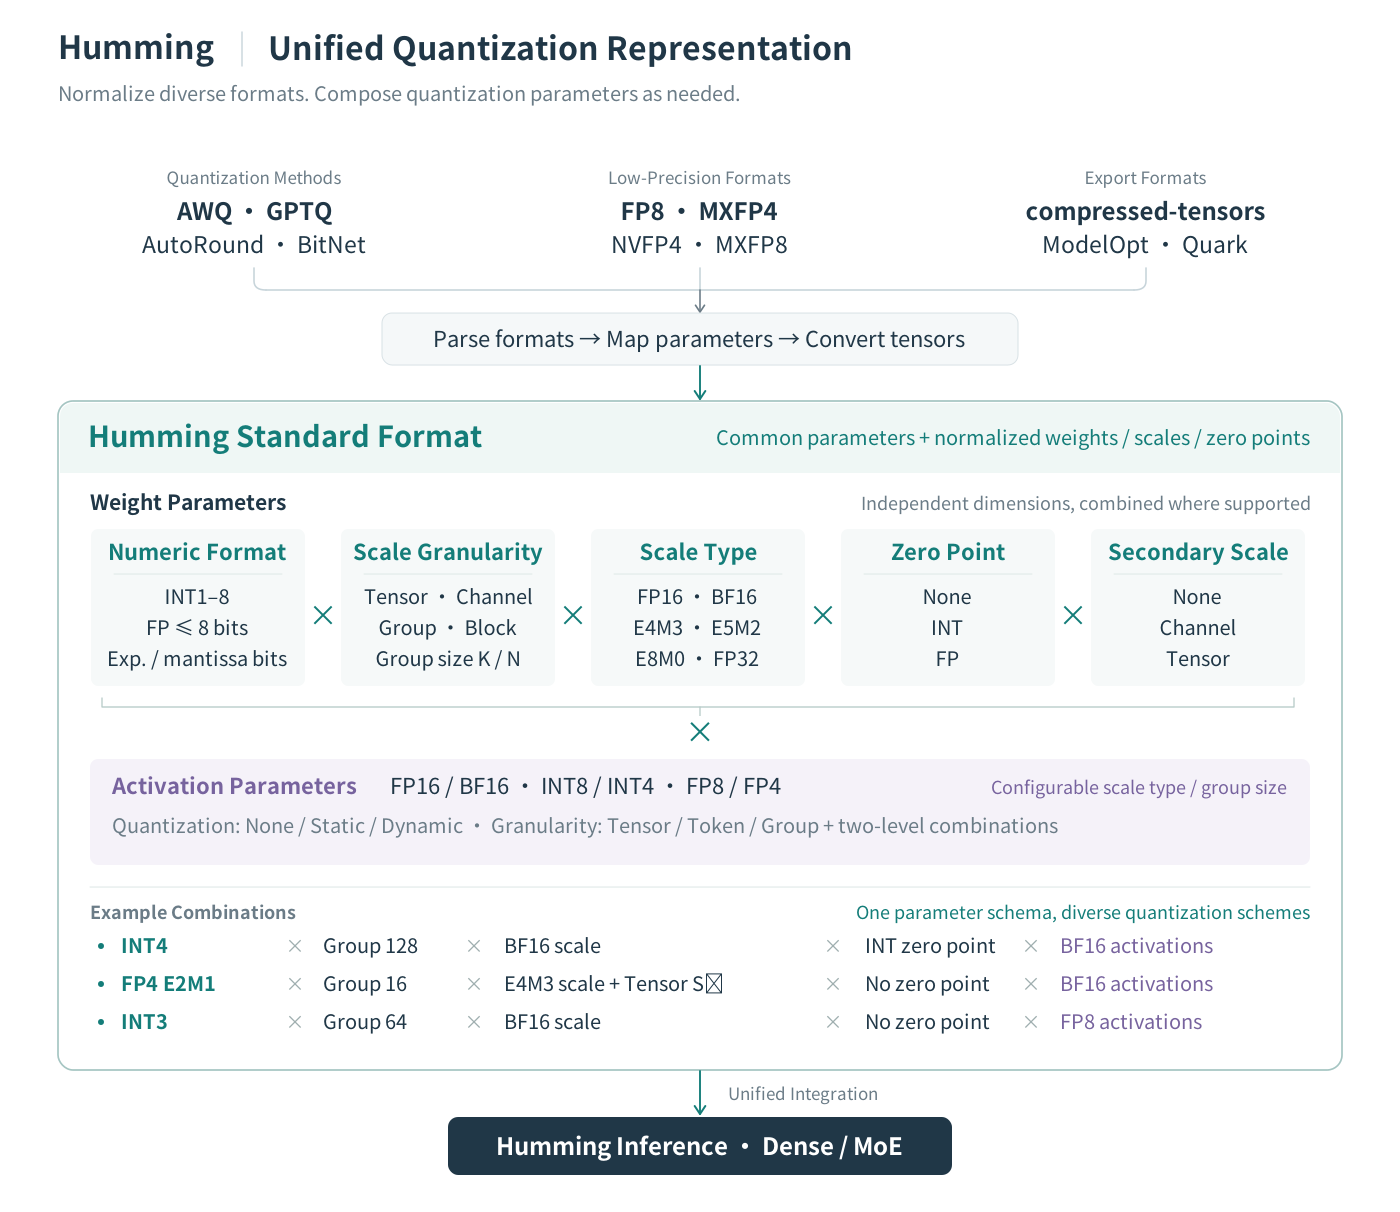
这种表示保留每种方案的量化语义,同时将权重格式、缩放粒度、缩放数据类型、零点和次级缩放描述为独立参数。激活有自己的数值格式和量化设置。这些参数可以在受格式和硬件约束的情况下组合。
例如,分组 INT4 权重可与 BF16 激活配对。采用不同缩放方案的低精度浮点权重使用同一参数系统。这为推理框架提供了针对不同来源模型的通用接口。
针对每种工作负载的调优和 JIT 编译
标准格式为不同导出格式提供通用表示。随后预处理会验证参数、填充维度,并将这些张量重新打包为目标内核适合的布局。Humming 将量化描述与权重形状、GEMM 类型、目标 GPU 和计算选项结合,以配置执行。
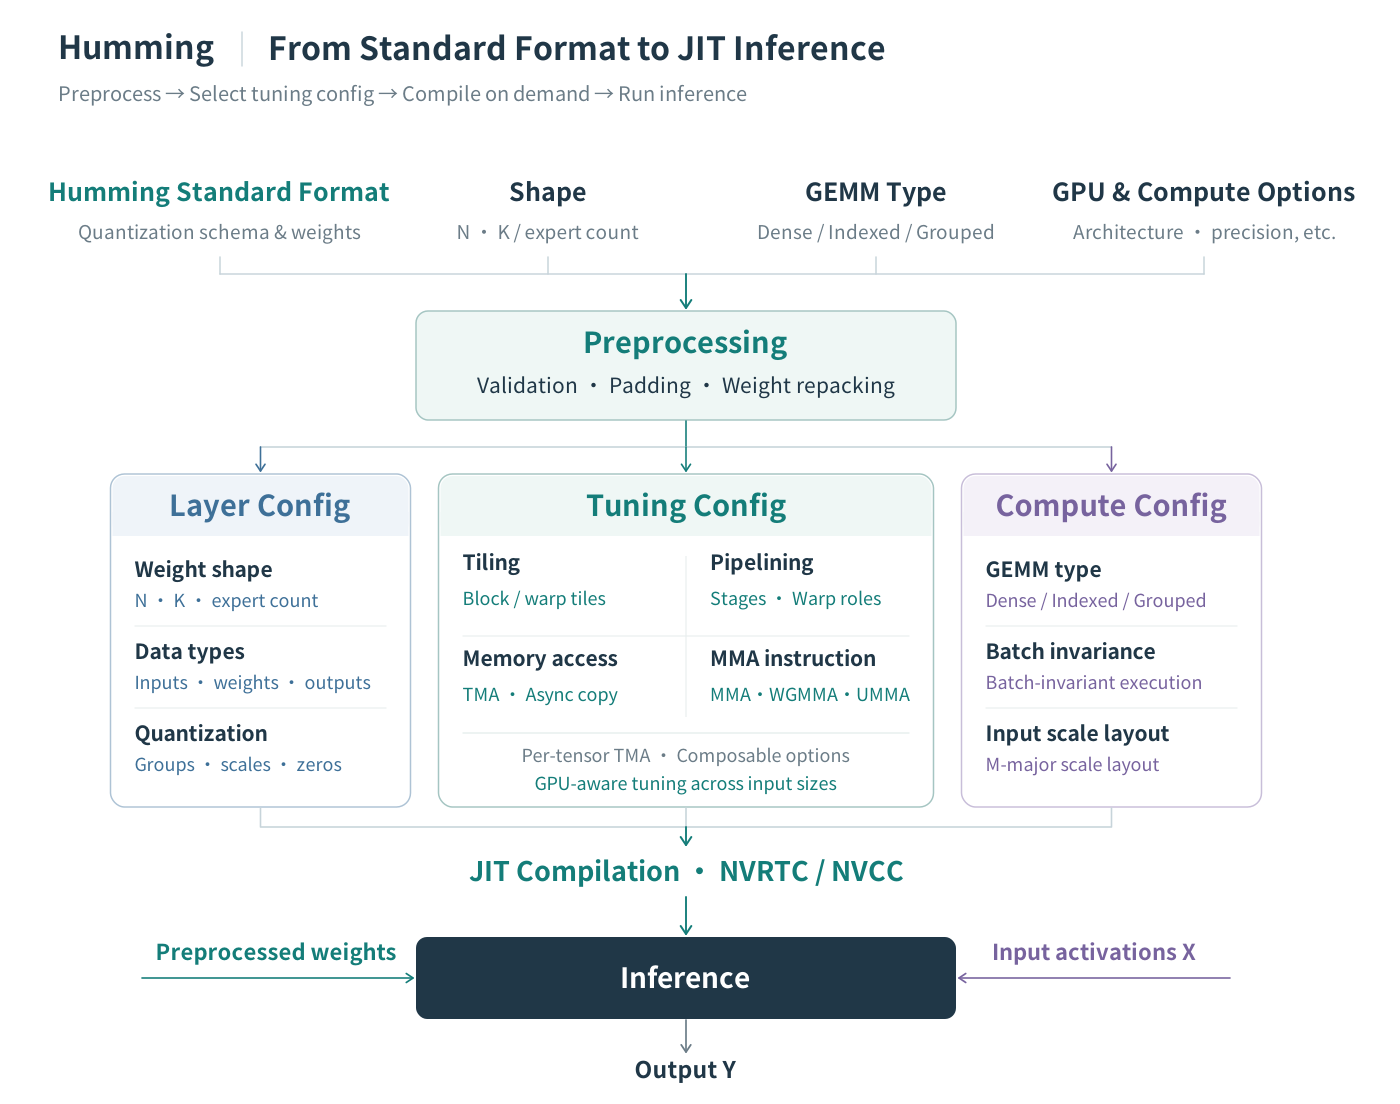
三种配置描述内核:
层配置描述张量形状、数据类型、量化参数和目标架构。
计算配置指定 GEMM 类型和计算选项,例如批次不变性和输入缩放布局。
调优配置选择 tile 形状、流水线阶段数、warp 特化、内存访问和 MMA 指令。它还控制并发和调度;TMA 可以按张量进行配置。
默认情况下,Humming 使用针对设备的启发式方法选择调优配置。它可以为不同输入大小范围准备不同配置,并在运行时分派到合适的内核。
Humming 的统一架构使其能够直接调优执行参数,并为不同工作负载选择流水线。在小批量大小下,使用异步复制(cp.async)和 MMA 的多阶段流水线可能优于围绕 TMA 和 UMMA 构建的流水线。在较大批量大小下,TMA 和 UMMA 可以提供更好的吞吐量。Humming 在同一配置与组件框架内同时容纳这两种执行路径,使其能够为每个工作负载选择更有效的策略。
这三种配置共同特化由 NVRTC 或 NVCC 编译的内核。编译后的内核会被缓存以便复用。推理会将所选内核与预处理后的权重和运行时激活值结合。
跨格式与架构的共享 CUDA 组件
在 CUDA 层面,Humming 将任务调度、数据移动、反量化与缩放、Tensor Core 计算以及输出处理组织为可复用组件。它提供标准流水线、warp 专用化流水线和专用 UMMA 流水线。这些流水线共享兼容组件,同时采用每种执行策略所需的数据流和同步方式。
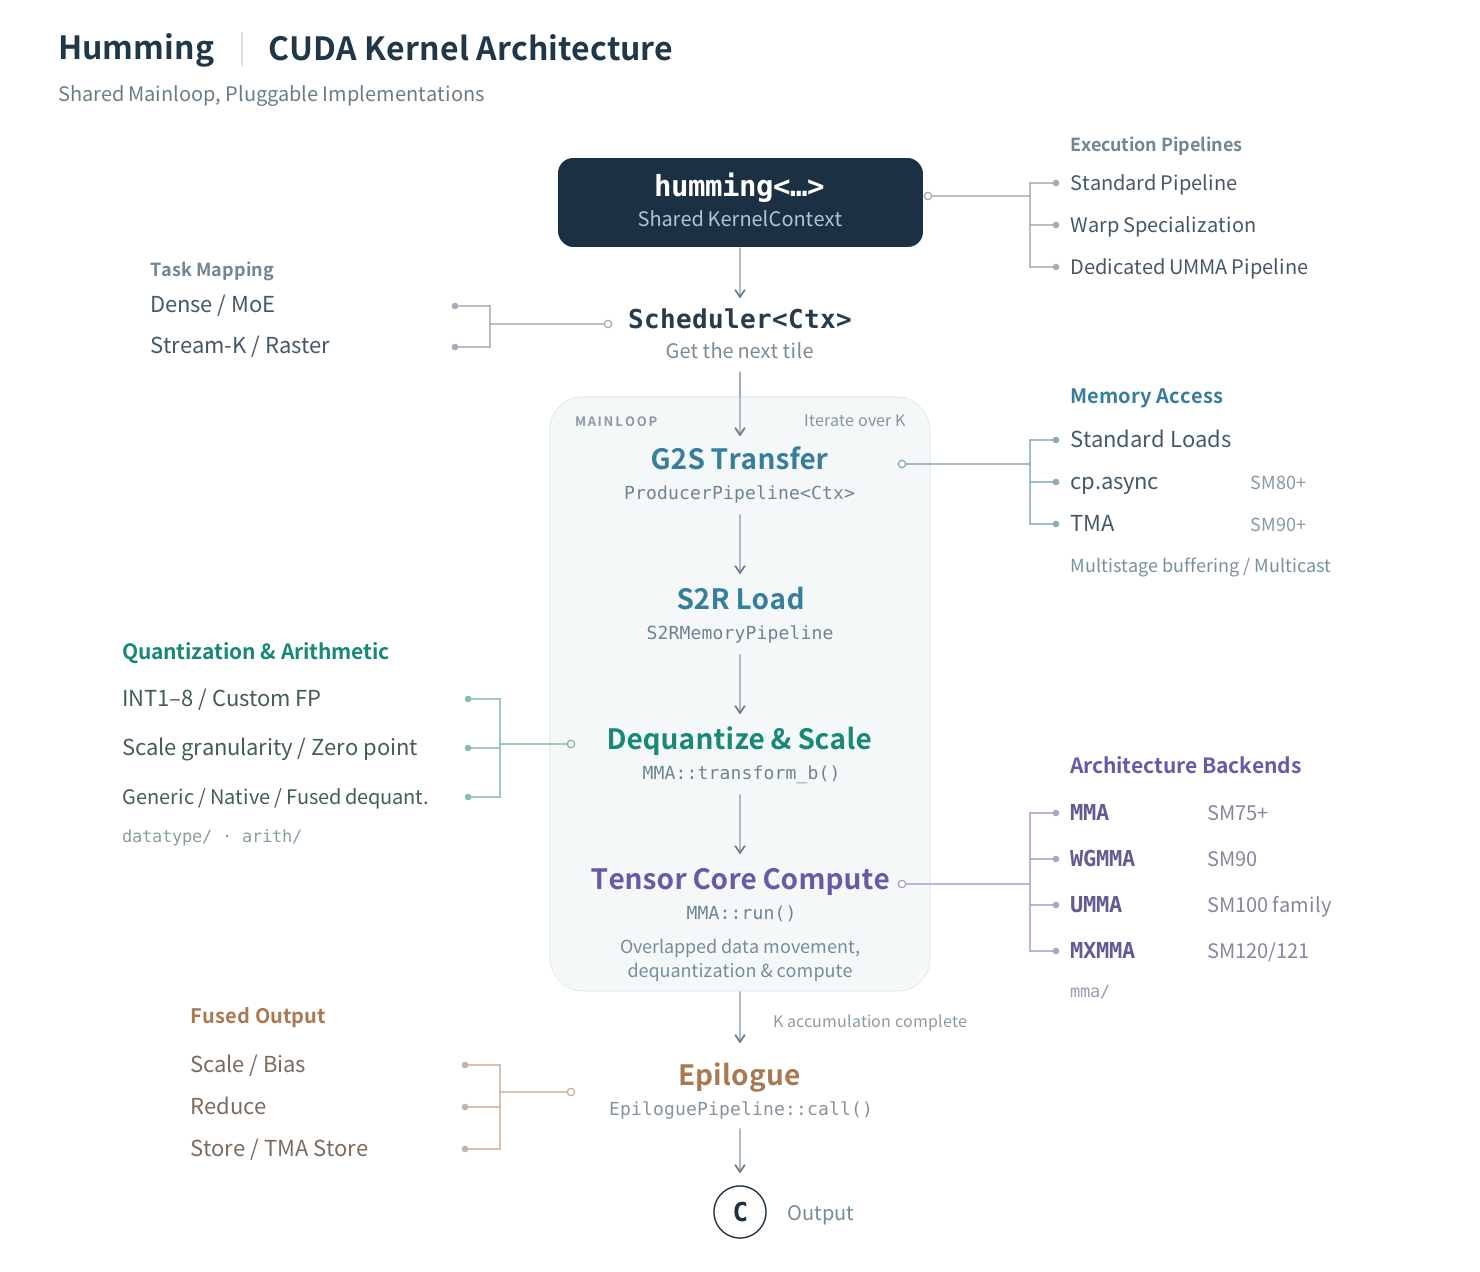
每组组件处理不同的变化来源:
数值处理负责量化格式。解码与算术组件会考虑位宽、整数或浮点表示、缩放因子和零点。反量化与缩放集成到内核计算中。
内存与计算后端负责 GPU 架构。Humming 为目标架构选择数据移动和 Tensor Core 实现,在支持时使用异步复制、TMA 和多播。
任务映射与调度负责稠密和 MoE 工作负载。每种 GEMM 类型使用合适的调度逻辑。缩放和偏置加法也可以融合到输出阶段。
JIT 编译根据这三种配置组合这些组件,并消除未使用的实现分支。因此,可以通过扩展相关组件来支持新格式或新架构。对共享组件的改进会使兼容配置受益,减少单独专用内核的重复开发与维护。
该 CUDA 实现轻量,避免了重量级内核框架依赖,也使 JIT 编译保持快速。在我们于配备 CUDA 13.4 的 H200 服务器上进行的单 W4A16 内核编译测试中,禁用编译缓存时,编译时间从使用 NVCC 的 CUTLASS 的 23.35 秒降至 Humming 使用 NVCC 的 1.82 秒或使用 NVRTC 的 1.88 秒。这降低了为新工作负载准备内核的成本,并使迭代调优更加实用。Humming 还会在模型预热期间并行编译内核。在我们的测试中,编译并加载覆盖单层 GEMM 所有受支持 M 大小的内核仅需约 2–4 秒,使得在推理前准备多个专用内核变得切实可行。
基于设备参数的性能调优
Humming 利用 GEMM 配置和设备参数对内核进行深度优化。量化格式、矩阵形状、GPU 指令支持、SM 数量、共享内存和寄存器资源都会影响执行选择,将低比特存储的优势转化为实际推理性能。
在现有 GPU 上实现高效的 W4A8-MXFP4 推理。Blackwell 之前的架构缺少原生 MXFP4 Tensor Core 支持,传统 W4A8-MXFP4 内核在较大 M 时可能受到反量化和缩放开销的限制。Humming 通过快速的 MXFP4 到 INT8/FP8 反量化路径解决此问题,在内核内将 MXFP4 权重转换为受支持的计算格式。在此设置下,该路径在较小 M 时显著优于传统 W4A8 实现,在较大 M 时接近 W8A8 性能。因此,诸如 H200 的 GPU 可以运行高性能 W4A8-MXFP4 内核,同时保留 4 位权重的存储优势。
为每种设备匹配反量化路径。相同的量化格式在不同 GPU 上可能受益于不同实现。Humming 为设备选择解码、数值转换和缩放路径,并将其与合适的内存访问和计算流水线搭配,以减少指令和数据移动开销。共享组件使这些优化可在兼容的稠密和 MoE 内核之间复用。
借助设备特定启发式规则提供丰富的调优控制。Humming 暴露 tile 形状、流水线阶段数、warp 专用化、TMA、MMA 指令、CTA 并发和 Stream-K 调度。设备特定启发式规则将 GEMM 形状与资源约束结合,以平衡并行性、数据复用和流水线开销,并随着输入大小变化选择不同的执行策略。开发者可以直接使用默认配置,或针对特定模型和部署场景进行细化。
广泛的设备支持
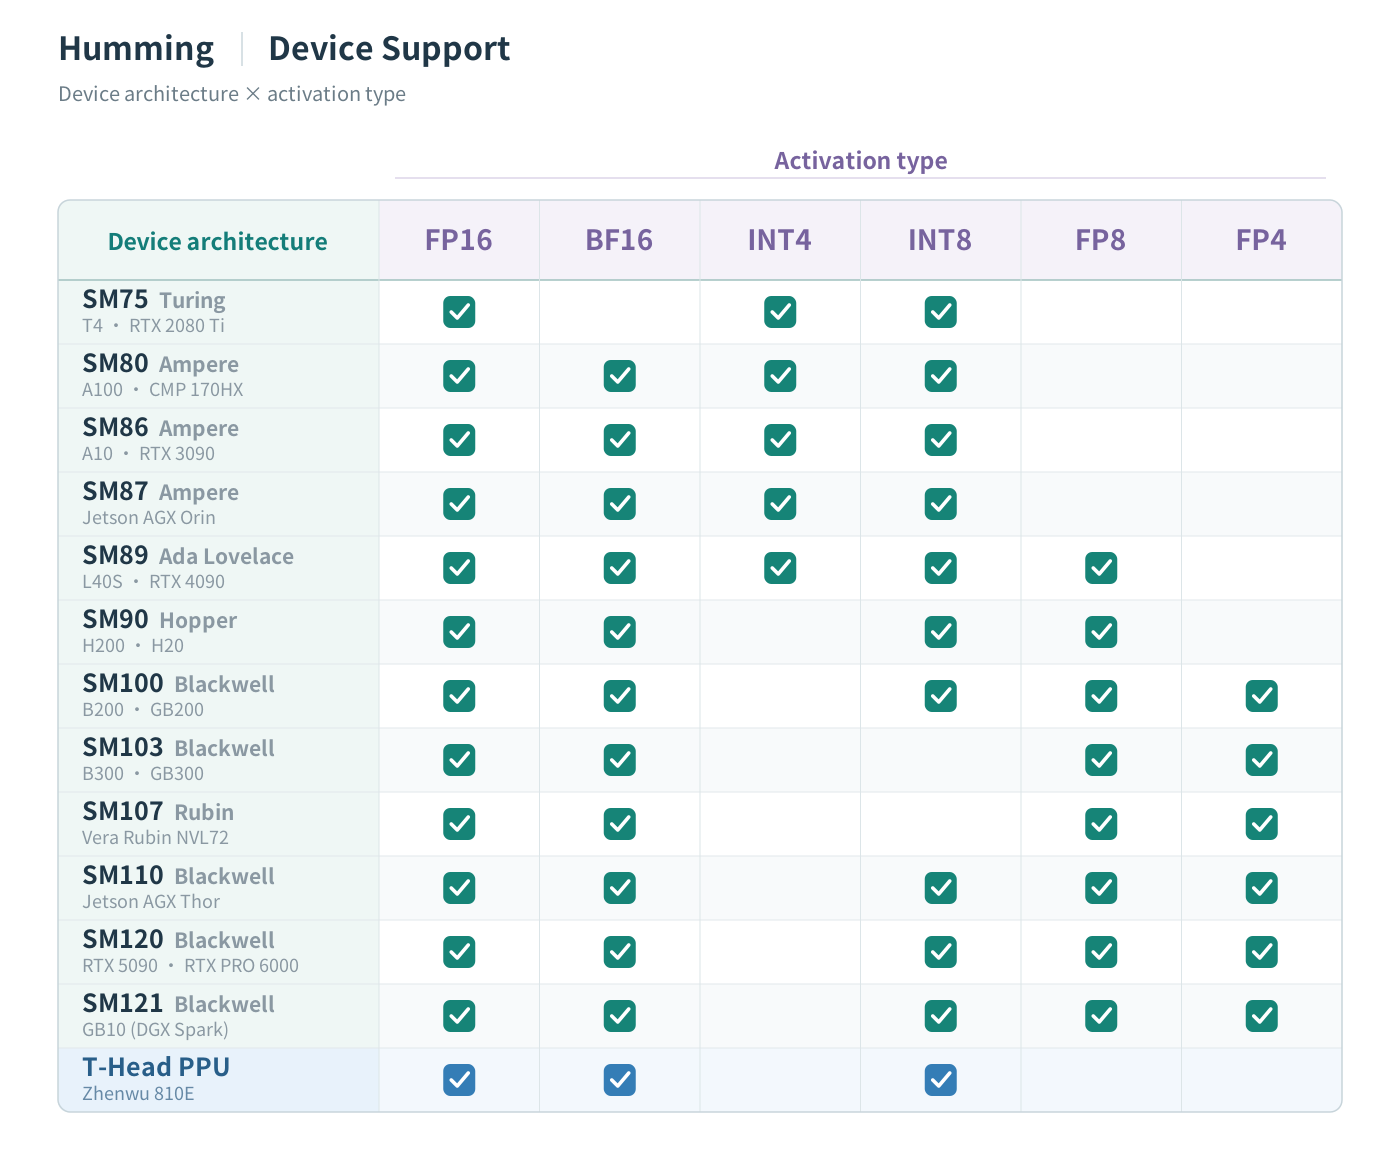
Humming 的统一架构实现了广泛的 GPU 支持。对于 NVIDIA GPU,Humming 完全支持从 Turing 及之后的每一种架构,将通用的量化计算框架带到多代硬件上。
统一的 JIT 架构还使将 Humming 扩展到其他兼容 CUDA 编程的 GPU 变得简单直接。Humming 已完全支持 T-Head 的 Zhenwu 810E,将其共享内核和调优能力带到更多硬件平台。
下图展示了 Humming 在每种设备上支持的高性能激活类型:这些类型能够充分利用设备的峰值计算能力。图中省略的一些类型仍可通过其他指令路径运行。例如,B300(SM103)上的 UMMA 指令不再支持 INT8 计算,但更早的 MMA 指令仍可执行 INT8 GEMM,只是性能显著降低。
量化支持
Humming 对量化类型的支持主要取决于激活类型与权重类型之间的兼容性。其统一的量化表示和内核架构允许各种整数和浮点权重格式与不同精度的激活配合使用,为模型精度和部署性能提供灵活选择。
下图展示了 Humming 支持的权重与激活类型组合。行表示权重类型,列表示激活类型,勾选表示支持的组合。结合上文的设备支持矩阵,它概述了每种硬件架构上可用的高性能量化计算路径。
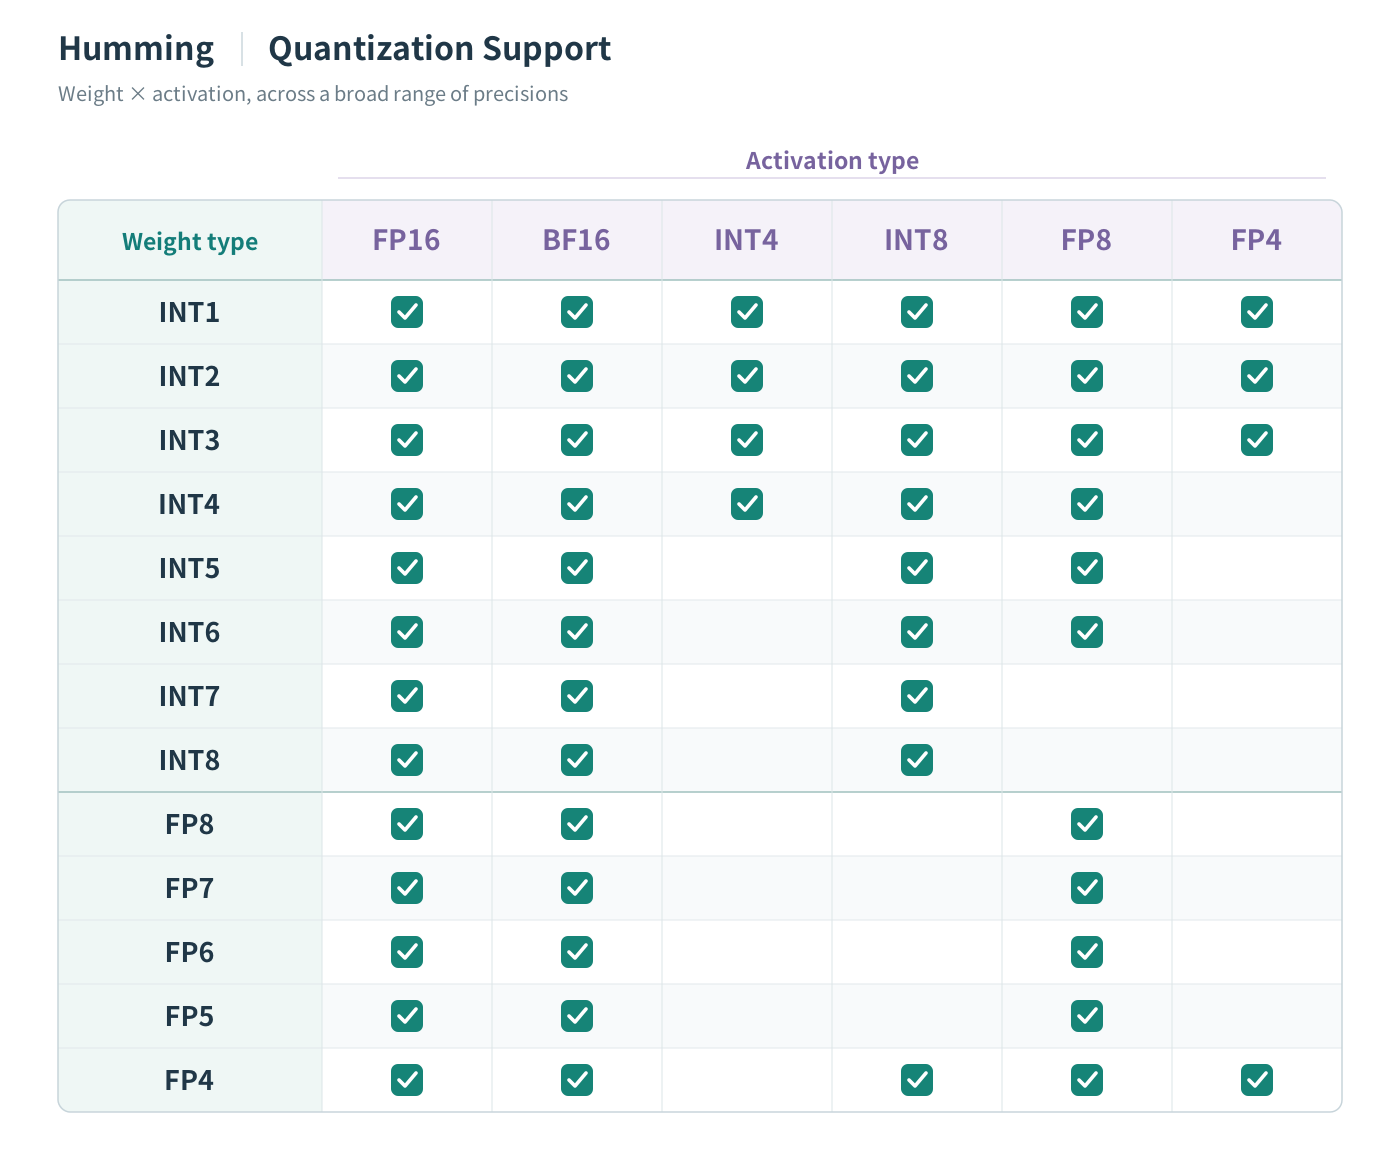
Humming 还支持一种指数位为零的特殊浮点格式,其可表示的值与相同位宽下的对称整数一致。例如,排除 -128 的 INT8 和 float8e0m7 都表示从 -127 到 127 的整数。这种格式的权重与相同位宽的 INT 权重具有相同的激活类型兼容性。Humming 会自动将符合条件的对称整数权重转换为这种格式,以加快反量化。
社区还发现了 Blackwell Tensor Core 中的两项隐藏能力:原生支持 float4e0m3 和 float8e3m4,这两种特殊浮点格式未在 PTX 类型系统中公开。Humming 在所有 Blackwell 架构上支持这些特性,包括数据中心的 SM100/SM103,以及面向工作站和个人计算的 SM120/SM121 设备。两种格式都已集成到其统一的量化和计算框架中,为低精度推理提供更多原生计算选项。Rubin 不支持这两种隐藏的 Tensor Core 格式,因此对这些原生计算路径的支持不会延伸到 Rubin。
性能
下面由 vLLM 社区运行的内核微基准测试测量 GEMM 性能,其中 M 覆盖从 1 到 8192 的每个 2 的幂。内核已充分预热,并在冷 L2 缓存下独立计时,样本之间有短暂停顿。MoE 加速比使用 Gateup 和 Down GEMM 延迟之和。每张图都标明了其基线、量化格式、矩阵维度和软件版本。
WnA16 是量化推理中最通用、使用最广泛的方法之一。它将低位权重与 FP16/BF16 激活相结合,在利用广泛可用的 16 位计算能力的同时,减少权重存储和内存流量。这使其适用于许多 GPU 代际和模型部署场景。W4A16 系列尤其受到社区关注,也是 Humming 优化工作的一个重点。
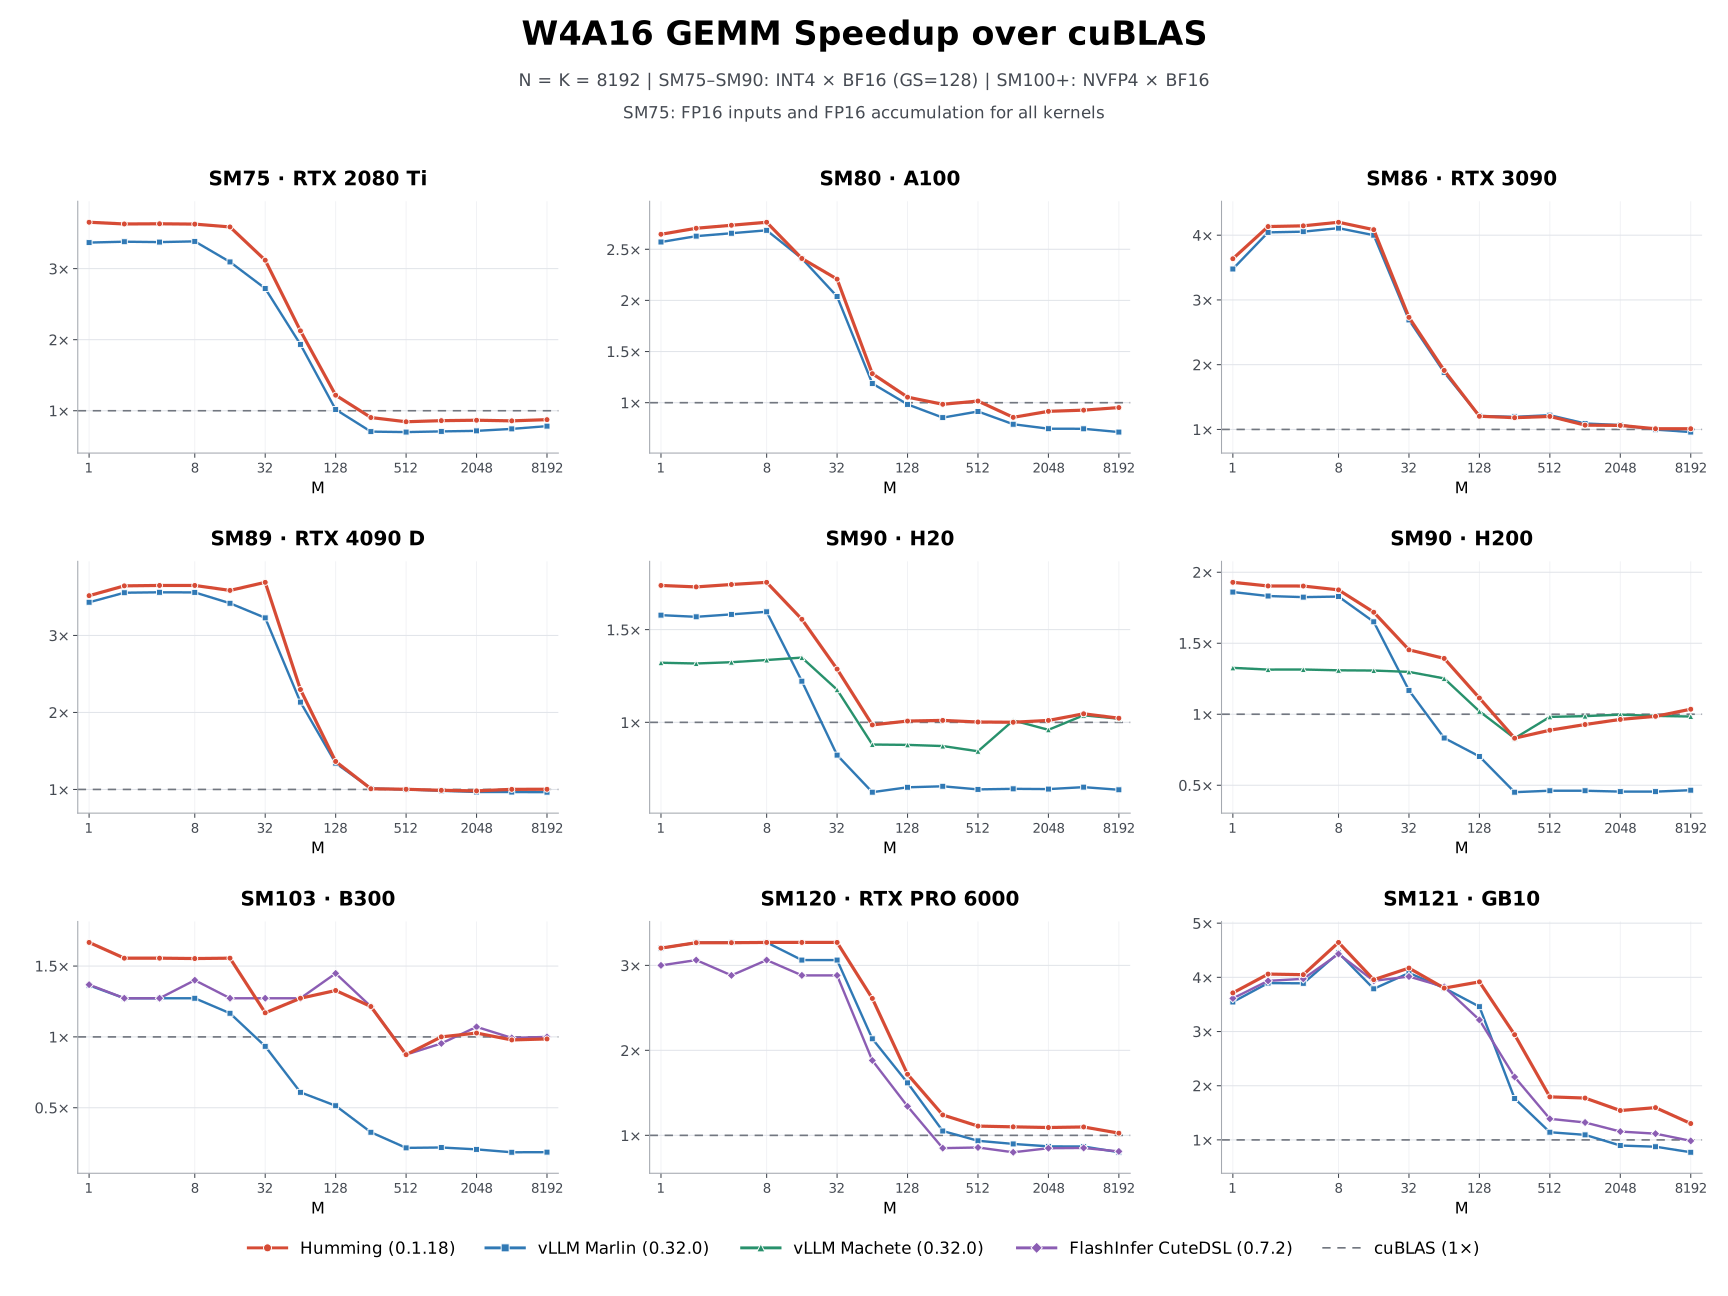
对于稠密 W4A16,Humming 在大多数测试配置中达到或超过 vLLM Marlin,并在若干 Hopper 和 Blackwell 工作负载上取得显著提升。下图使用 cuBLAS 作为通用基线。在小批量下,Humming 在多种设备上带来约 3–4 倍加速。随着批量增大,它继续高效利用硬件,在 H200 的大批量工作负载上达到约 Marlin 的两倍性能,在某些 B300 场景中达到其性能的三倍以上。
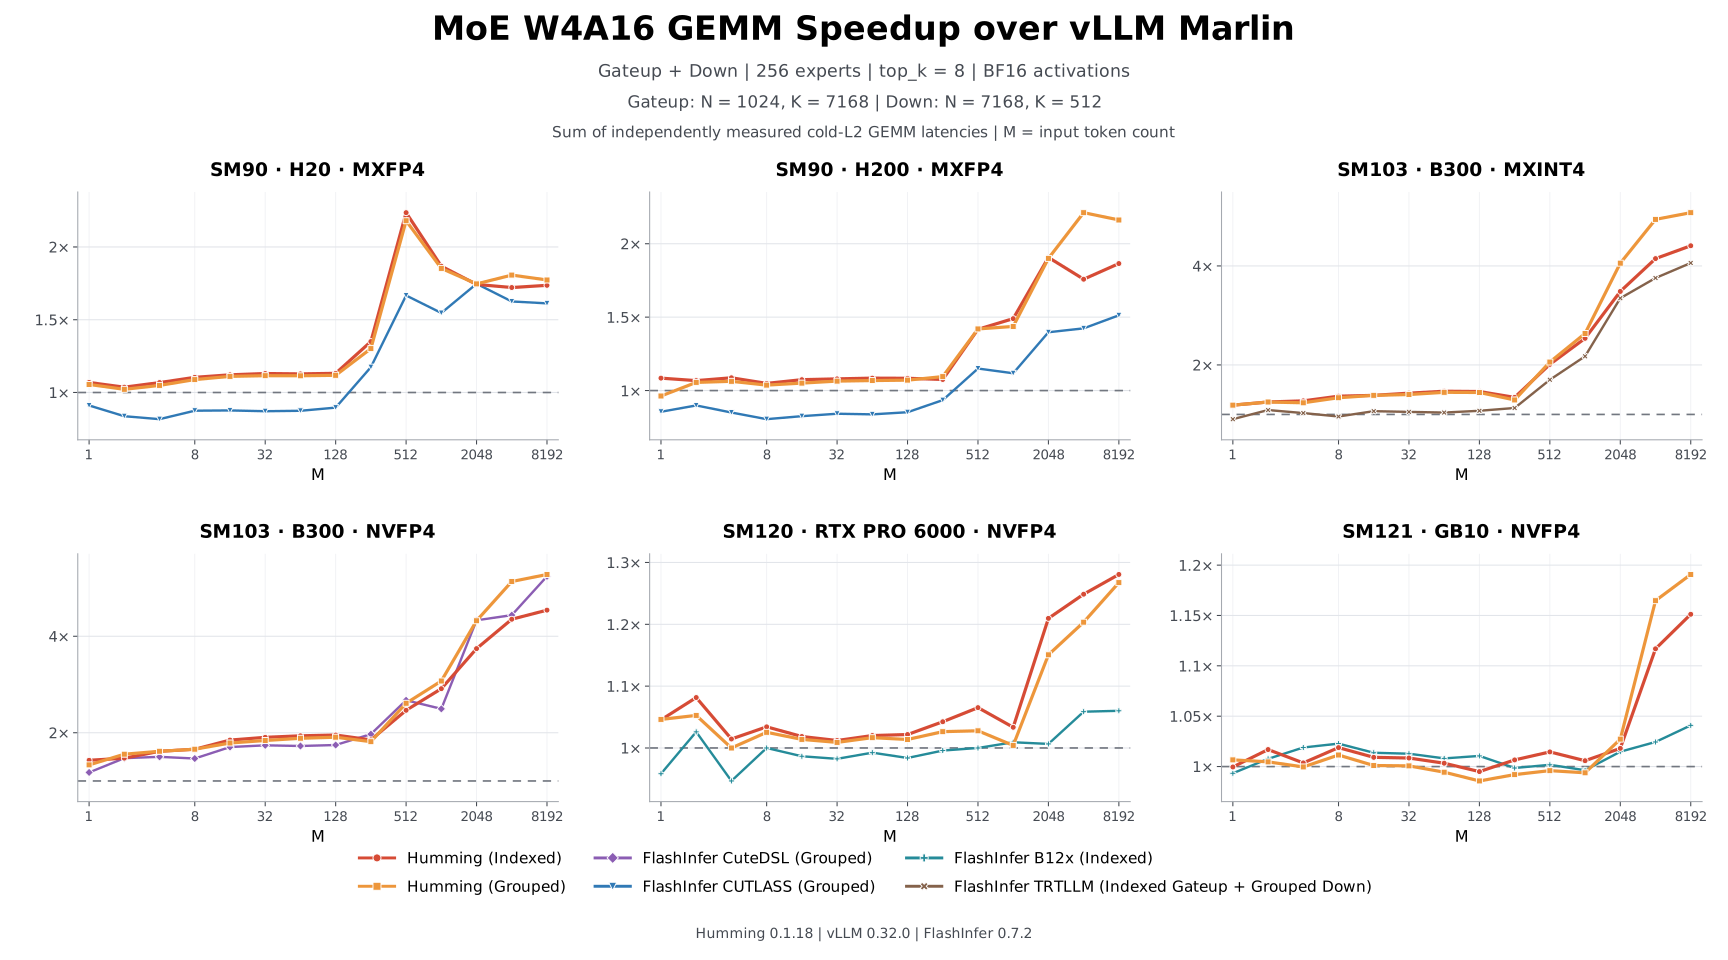
这些收益也延伸到 MoE。对于 token 分布在多个专家上且每个专家的工作量随负载变化的工作负载,Humming 提供高效的 Indexed 和 Grouped 路径。下图中,H20 和 H200 上的 MXFP4 W4A16 在若干中到大批量场景中达到约 Marlin 的两倍性能。在 B300 上,MXINT4 和 NVFP4 路径在大批量下取得更大收益,其中 Grouped 路径达到约 5 倍。SM120 和 SM121 上的结果还表明,Humming 在一系列工作负载上优于 Marlin 以及相应的 FlashInfer 实现。
Humming 的优化还从 W4A16 扩展到其他 WnA16 组合。其共享反量化与计算路径在不同位宽的整数和浮点权重下都能提供强劲性能,包括 INT1、INT2、INT3 以及 FP4 到 FP8。下图展示了这些格式在中小批量大小下的广泛收益,其中 SM120 上的最低位宽配置超过 BF16 cuBLAS 性能的 5 倍。在 H20 上的大批量大小下,多种位宽保持接近 BF16 cuBLAS 的计算效率。这使模型能够在精度、存储和吞吐量之间进行更细粒度的选择。